

过去几年,大模型的发展不断验证Scaling的力量:模型的能力随数据/模型规模与计算投入持续增长。
进入具身智能,这套逻辑面对的是一个更复杂的现实——机器人没有互联网。
语言模型可以从人类长期积累的文本、图片和视频中学习,机器人则需要在物理世界里亲自获得经验。真机运行、遥操作、硬件部署、场景搭建、数据治理,每一条有效训练数据背后,都有真实的物理成本。
而真实世界几乎无法穷举。物体、位置、光照、重量、材质、环境和任务不断变化,仅靠机器人自身采集,很难快速覆盖如此庞大的分布。
于是,Human Ego Data正在成为具身基础模型新的数据来源。
人类每天都在与物理世界交互。拿起杯子、打开抽屉、整理物品、使用工具……第一人称视角记录了人在真实环境中看到什么、如何行动,以及动作如何改变周围的世界。这些经验丰富、多样,也更容易走向规模化。
问题随之推进了一步:Human Experience如何真正变成Robot Capability?
人手和机械臂拥有不同的形态、运动学结构和控制空间。人类完成一个任务时产生的动作,无法直接转化为机器人控制指令。Human与Robot之间的embodiment gap,决定了Ego数据进入具身基础模型之后,还需要经历一次关键的能力转换。
近日,原力无限(INFIFORCE)发布最新具身基础模型 AtomEgo。该研究由原力无限与招商局狮子山人工智能实验室、香港大学 、同济大学等团队共同完成。(论文:《AtomEgo: Exploring Ego–Robot Integration for Embodied Foundation Model Pretraining》;地址:https://agentic-intelligence-lab.org/files/AtomEgo.pdf)
AtomEgo是原力无限面向Human Experience Scaling打造的具身基础模型,探索如何将可规模化的人类第一人称真实世界经验转化为机器人的可执行能力。模型围绕Human Ego Data与Robot Data的跨本体学习,系统研究直接联合训练、渐进式具身对齐与World–Action Modeling等不同技术路径,并验证了结构化具身对齐在跨越Human–Robot Embodiment Gap中的关键作用。AtomEgo将具身基础模型的Scaling从单纯的数据规模进一步推进到“数据如何有效转化为能力”,形成Data Scale × Alignment Quality → Capability Gain的核心研究判断,为机器人从更广泛的人类真实世界经验中持续学习提供新的技术路径。
AtomEgo围绕Ego数据进入具身基础模型的不同方式展开系统研究。在统一的数据、训练和真实机器人评测体系下,研究团队比较了三种Ego–Robot integration strategy,并得到一个清晰的结果:同样引入Human Ego Data,不同的训练方式会产生完全不同的能力增益。
渐进式具身对齐显著提升了真实机器人表现;直接联合训练可获得一定但有限的增益;Vanilla地引入基于Ego数据的未来视觉预测反而会导致性能下降。进一步的显式latent alignment实验表明,单纯拉近Human与Robot的表征,并不能保证更好的迁移效果。
这些结果让具身基模Scaling多了一个关键变量:Alignment Quality。
AtomEgo由此验证了一条关于有效Scaling的经验规则:Data Scale × Alignment Quality → Capability Gain
数据规模决定经验的边界,对齐质量决定经验转化为能力的效率。
01
Human Experience,正在成为机器人的新经验来源
具身基础模型需要更丰富的数据。
机器人面对的物理世界天然具有长尾特征。同一个“拿起杯子”的任务,杯子的材质、大小、重量、位置可以不同,环境中的光照、遮挡、背景也始终变化。要靠机器人逐一经历这些情况,需要付出巨大的采集成本。
Human Ego Data提供了一个天然存在的真实世界经验库。
第一人称视频覆盖大量日常操作,也保留了人与物体发生交互时的视觉变化和行为过程。从具身学习的角度看,这些数据的价值在于提供更广泛的环境、物体和任务分布,让模型接触机器人自身数据尚未覆盖的经验。
这也是Human Video Scaling近来受到关注的原因。
但Ego数据进入模型,只完成了第一步。Human与Robot拥有不同的身体,也使用不同的动作空间。模型需要从Human Experience中提取能够跨越本体差异的知识,再将其落到机器人可执行的动作上。
因此,AtomEgo关注的核心问题非常具体:Ego数据应该以什么方式进入具身基础模型,才能产生有效的能力迁移?
02
三条路线,回答Ego数据应该怎么用
为研究这一问题,AtomEgo将三种不同的Ego–Robot integration strategy放入统一实验框架进行比较。
研究使用的数据覆盖Human Ego和多种Robot Data。原始数据经过质量筛选、语义空间映射和动作归一化等处理后进入训练,并采用一致的post-training与真实机器人评测流程。

经过质量筛选,最终训练集包含约2659.5小时数据、334,054个episodes,涵盖Human Ego、不同机器人本体数据以及任务匹配的Human–Robot Alignment Data。
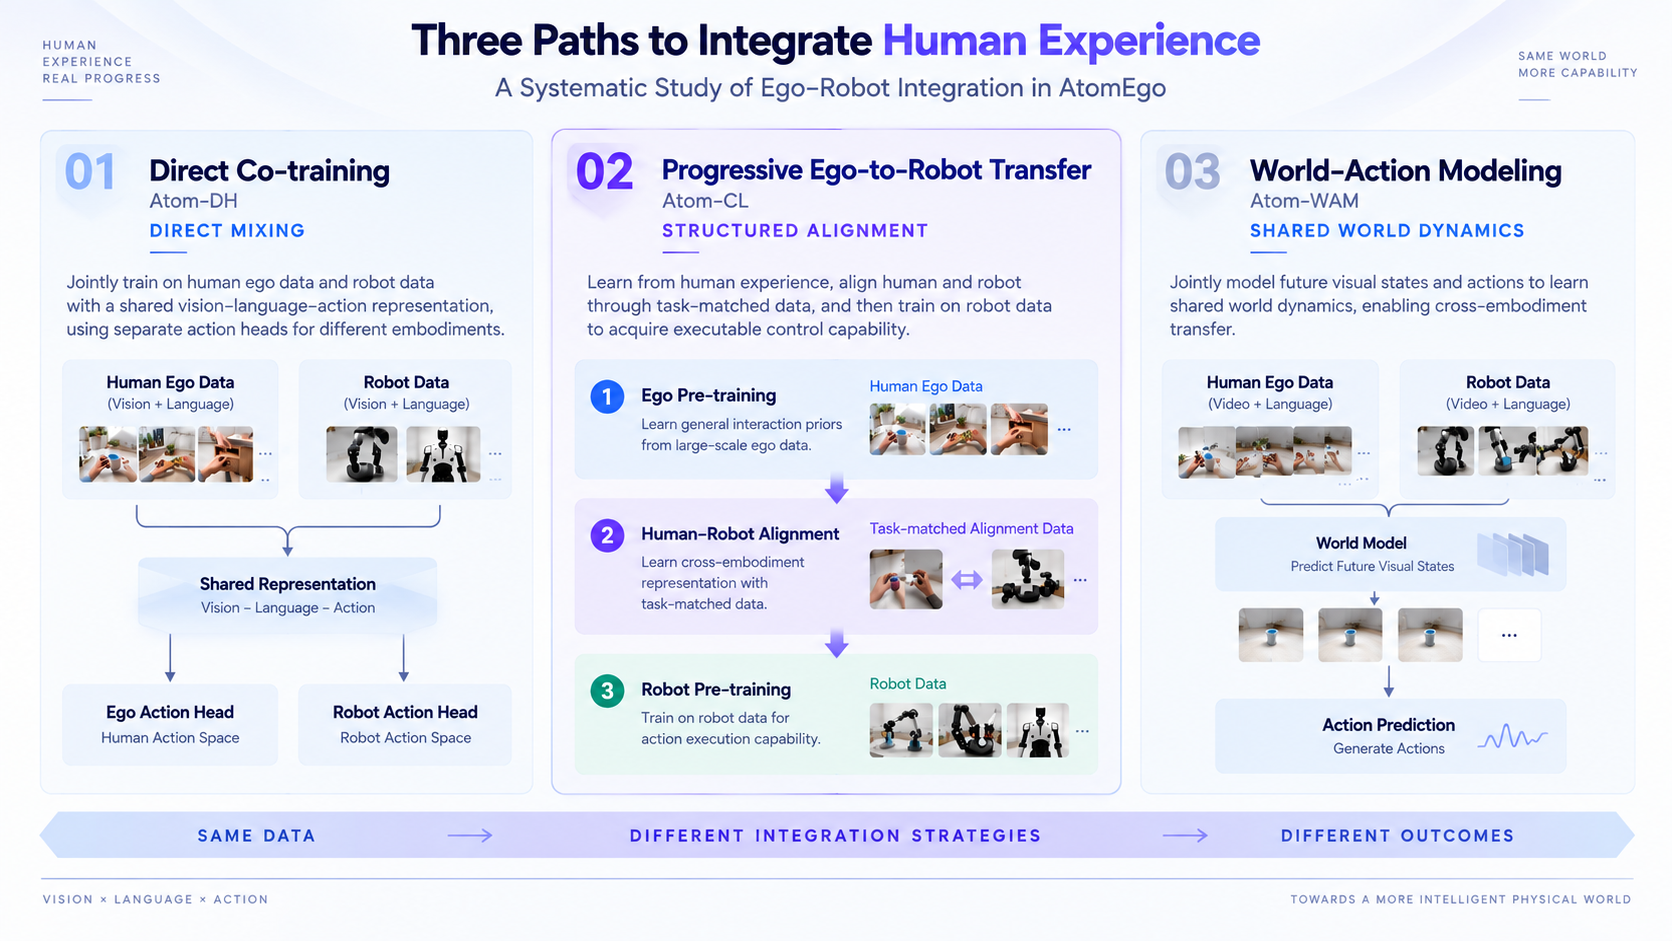
在统一的数据基础上,研究团队设计了三条路线。
Atom-DH:Direct Co-training
Human Ego与Robot Data共享视觉、语言和动作表征,并通过独立的Action Head处理各自的动作空间。它验证的是最直接的联合训练方式:两类数据进入同一模型,通过共享表征实现知识迁移。
Atom-CL:Progressive Ego-to-Robot Transfer
训练被拆分为三个阶段:Ego Pre-training → Human–Robot Alignment → Robot Pre-training
模型先从Ego数据中学习真实世界交互先验;随后利用任务匹配的人类与机器人数据建立跨本体对应关系;最后回到Robot Data,将获得的经验落到可执行控制。
Atom-WAM:World–Action Modeling
这条路线从世界动态入手。无论人手还是机械臂,与物体发生交互都会改变环境状态。Atom-WAM联合预测未来视觉状态和动作,尝试通过共享的world dynamics完成跨本体迁移。
相同的数据来源,不同的integration strategy,最终给出了明显不同的答案。

03
跨越Embodiment Gap,关键是建立一座“桥”
三条路线中,采用渐进式具身对齐的Atom-CL表现最好。
它首先通过Ego Pre-training吸收Human Experience中的真实世界交互先验,随后增加一个专门的Human–Robot Alignment阶段。
在这一阶段,人类与机器人执行任务匹配的操作。研究团队将人手与机器人末端执行器转换到统一的End-Effector Representation,让模型寻找不同身体完成相同任务时共享的空间交互结构。
这里的重点在于任务相关性。
模型需要建立的联系,是“这个动作如何服务于任务”,以及“动作与环境变化之间有什么关系”。完成具身对齐后,训练再回到Robot Data,将已经形成的交互表征落到真实机器人控制。
在AtomEgo当前实验中,这一阶段使用了约20小时Task-Matched Human–Robot Alignment Data。研究并未对不同Alignment Data规模进行系统消融,因此20小时并不代表某种最优值;它验证的是这层“桥梁”本身具有价值。
由此形成一条清晰的能力迁移路径:Human Experience → Embodiment Alignment → Robot Capability
真实机器人实验也呈现出一致趋势。
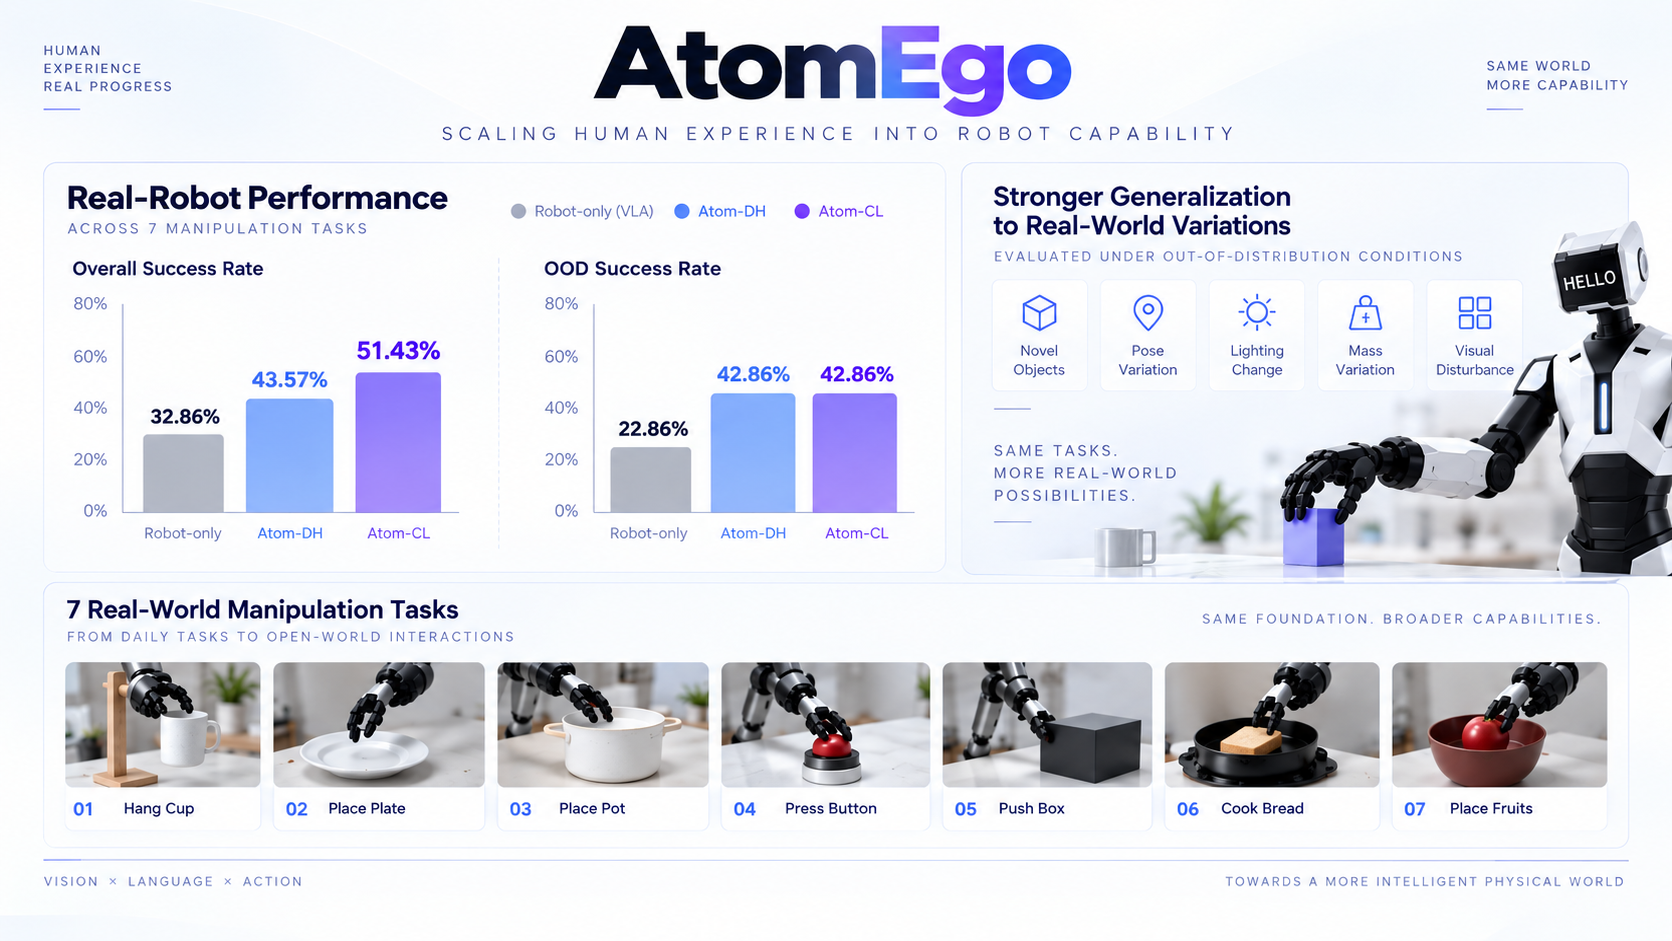
Robot-only VLA baseline综合成功率为32.86%,直接联合训练的Atom-DH达到43.57%,采用渐进式具身对齐的Atom-CL进一步达到51.43%。
在物体、位置、光照、重量和视觉干扰等OOD条件下,Robot-only baseline成功率为22.86%,两种Ego-pretrained VLA均达到42.86%。
这些结果表明,Human Experience能够为机器人提供可迁移的真实世界先验;加入结构化具身对齐后,这些先验可以更有效地进入机器人控制体系。
04
More Data,也可能带来Negative Transfer
Atom-WAM的结果提供了另一组重要证据。
这条路线尝试通过未来视觉预测寻找Human与Robot共同的world dynamics。从直觉上看,这个假设很合理:执行主体可以不同,但物体受到作用之后遵循相同的物理规律。
实际训练却出现了性能下降。
Robot-only WAM baseline综合成功率为28.57%,加入Ego数据后的Atom-WAM为20.71%。
问题可能来自视觉预测目标本身。
未来画面中同时存在人的外观、机器人的外观以及不同本体特有的运动模式。这些信息有助于预测下一帧,却未必能够帮助机器人判断下一步应该执行什么动作。
这个negative result给AtomEgo的研究增加了重要的一面:Human Video中包含大量信息,具身学习需要识别其中真正与action和task相关的部分。
数据进入模型的方式,会直接影响模型最终学到什么。
05
Human和Robot“更像”,也未必更好
研究团队进一步测试了另一种直觉:既然Human与Robot之间存在representation gap,那么主动缩小这个gap是否能够进一步改善迁移?
AtomEgo在Atom-DH中加入Optimal Transport regularization,对Human与Robot的action latent进行显式分布对齐。
结果显示,加入OT之后,综合成功率从43.57%下降至35.00%,OOD成功率从42.86%下降至31.43%。
Representation Analysis提供了进一步解释。
Atom-DH能够获得很高的Human–Robot matched-task representation similarity,但与此同时,不同任务之间的表征也更加接近;表现更好的Atom-CL则保留了更强的task discrimination。
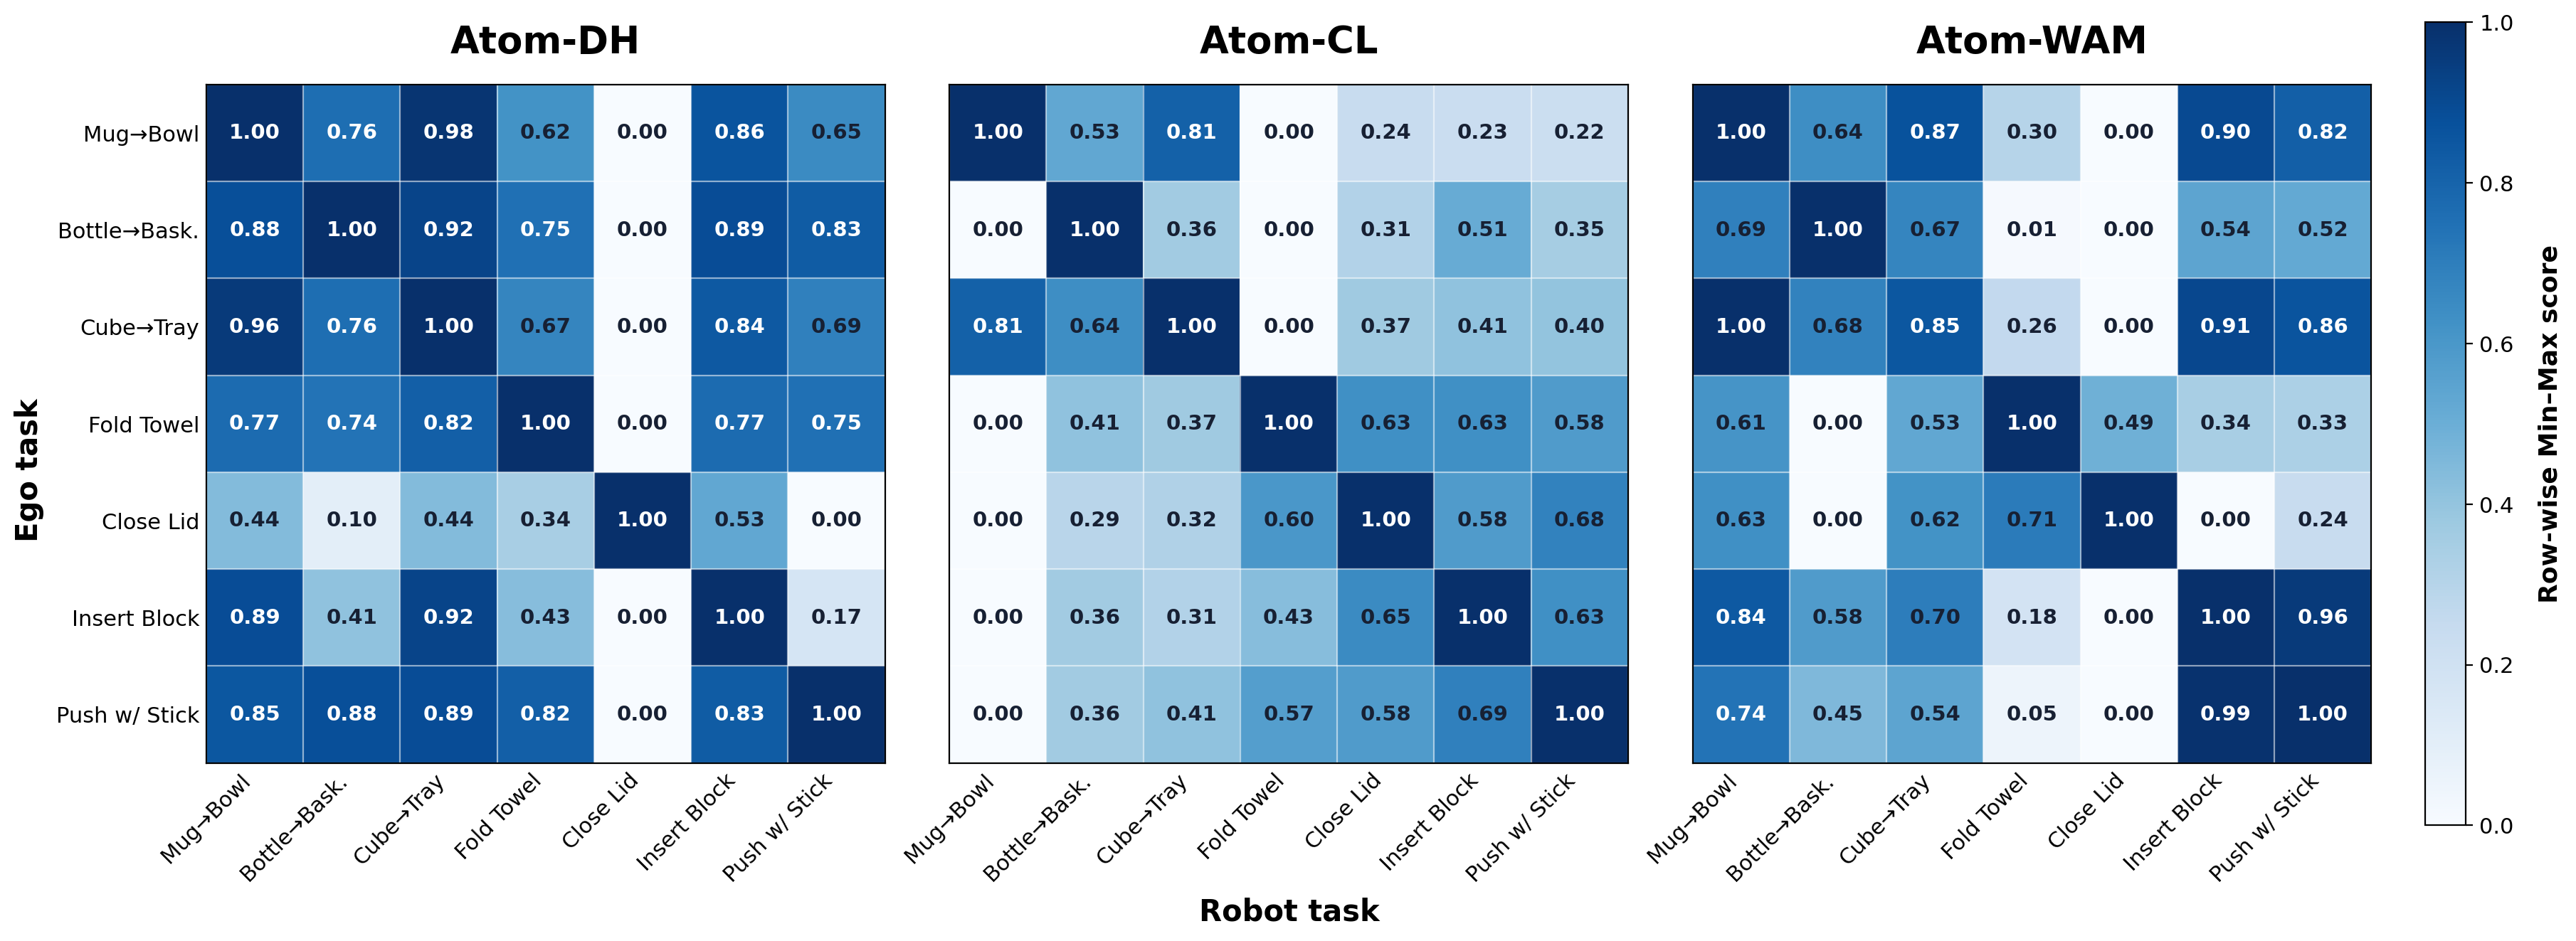
这说明跨本体学习需要同时处理两个目标:找到Human与Robot之间可以共享的结构,同时保留不同任务之间真正有用的差异。
如果只追求representation similarity,模型可能同时抹掉与任务相关的信息。
因此,AtomEgo所强调的Alignment Quality,并不等同于简单的“距离更近”。它指向的是一种更具体的对齐:Task-discriminative,Action-relevant。
06
从Data Scaling,到Capability Scaling
AtomEgo的几组实验放在一起,给出了一个值得关注的结果。
Human Ego Data扩大了模型能够接触的真实世界经验范围;结构化具身对齐帮助这些经验跨越embodiment gap;不同的integration strategy,则决定了迁移最终产生增益还是negative transfer。
因此,当Human Experience开始规模化进入具身基础模型,单纯比较数据量已经无法完整描述Scaling效果。数据能否转化为能力,同样重要。
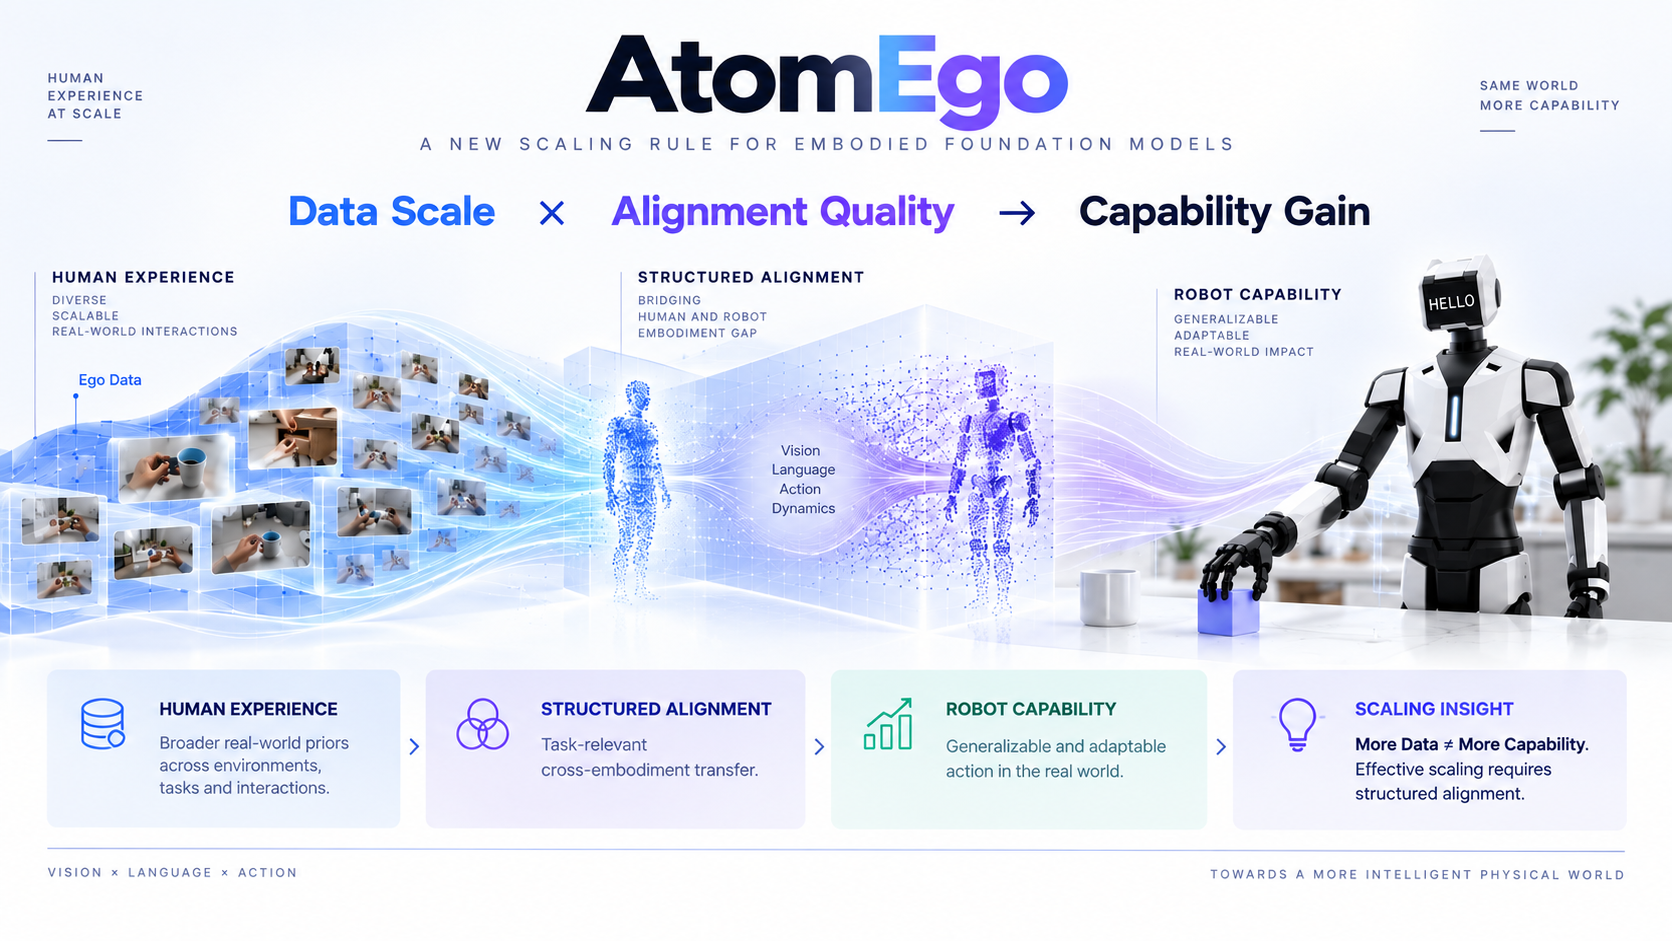
AtomEgo将这一关系概括为:Data Scale × Alignment Quality → Capability Gain
它回答的,是具身智能进入大规模Human Data时代之后必须面对的问题:How does data become capability?
从这个角度看,未来具身基模的数据体系可能拥有更清晰的分工:Human Experience扩展经验分布,Alignment Data建立跨本体连接,Robot Data完成真实执行能力的Grounding。
三者共同决定机器人最终能够获得多少新的能力。
具身智能的Scaling,也因此从“积累更多数据”向前走了一步——让更多经验真正成为能力。
07
AtomEgo,让机器人学习人类已经拥有的经验
AtomEgo是原力无限围绕具身大脑AtomBrain持续推进的一项基础模型研究。
作为原力无限首席科学家,陈佳玉教授及其研究团队正在围绕Ego原生模型、因果世界模型、持续学习后训练等方向,研究机器人如何基于真实世界经验不断形成新的能力并应用于真实世界。
此前,AtomVLA、HiMem-WAM等工作分别从预测式世界模型与长程记忆等方向推进相关研究;AtomEgo进一步把视角推向数据源头:考虑到机器人自身经验有限,人类已经积累的海量真实世界经验如何成为具身智能新的学习来源?
这也与原力无限正在构建的技术体系形成衔接。
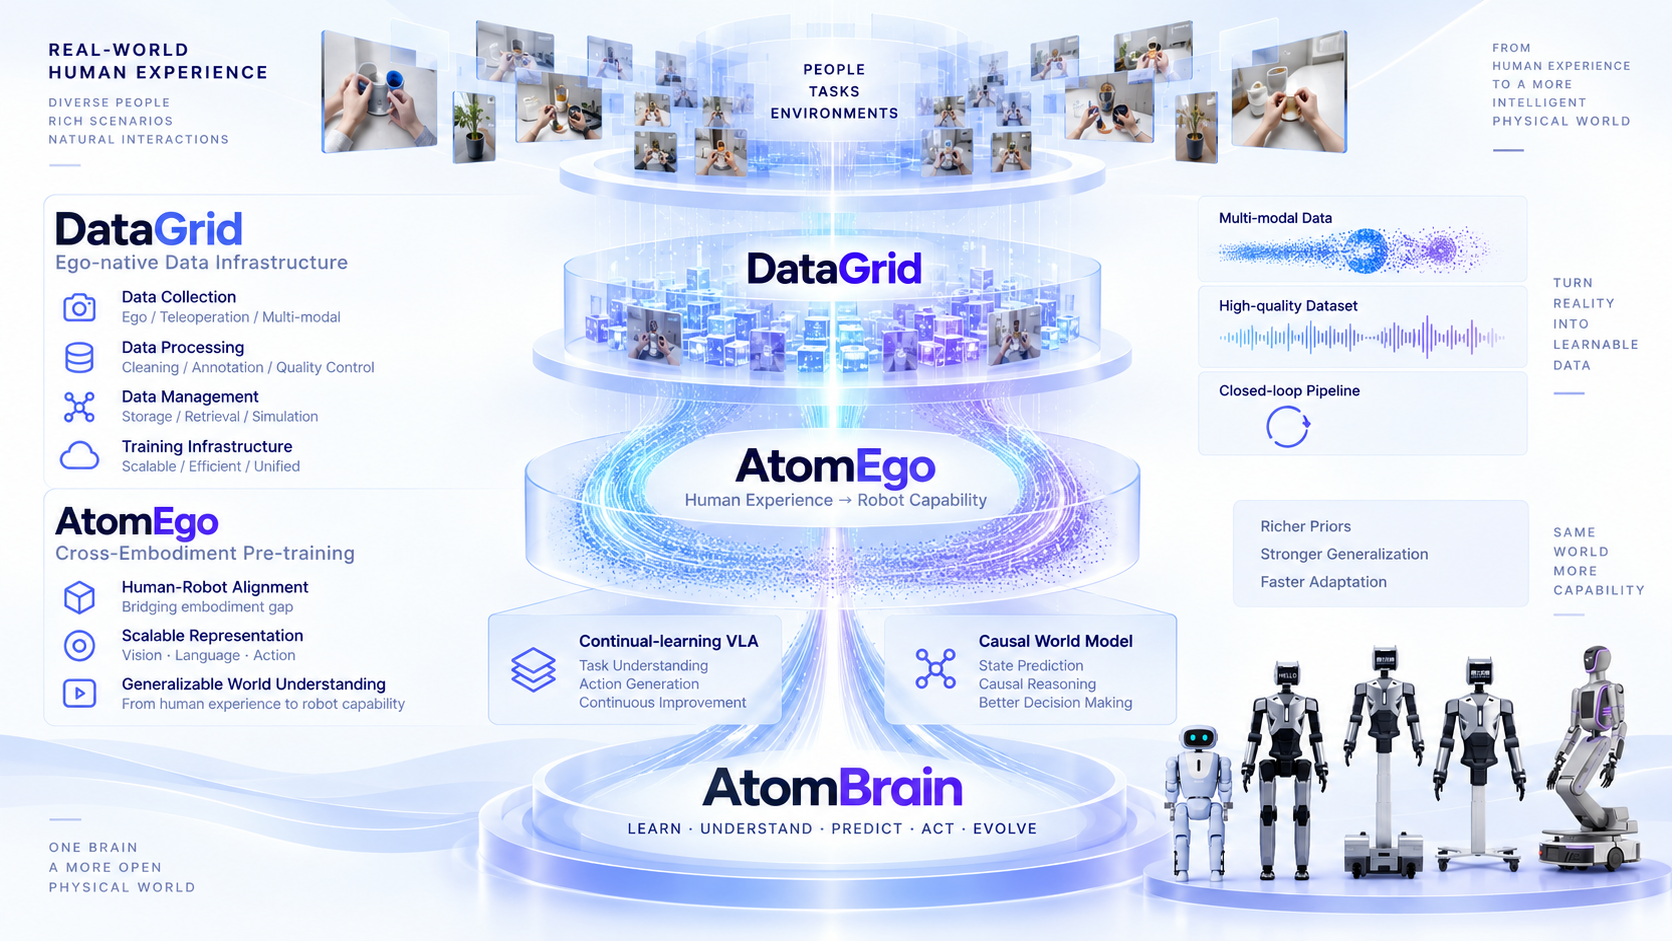
DataGrid面向真实世界进行第一人称数据获取;AtomEgo研究Human Experience跨越embodiment gap进入具身基础模型的方法;最终汇入具身大脑AtomBrain:从真实世界获得经验,从经验中形成能力,再通过持续交互不断进化。
语言模型的Scaling建立在人类已经创造的知识之上。
具身智能面对的物理世界,同样沉淀着大量人类已经拥有的经验。我们拿起杯子、打开抽屉、使用工具、整理房间,在日复一日的生活和生产中完成了无数真实交互。
这些经验已经存在。让机器人学会利用它们,会是具身智能下一阶段Scaling的重要路径。
从Human Experience到Robot Capability,AtomEgo正在探索其中最关键的一步。